Document AI OCR
HWP·PDF 공고문 Document AI · 주요 필드 F1 0.985 · 일 약 2,000건
Document AI · Information Extraction
Built withPython · HWP/HWPX · PDF · Gemini 2.5 Flash-Lite · ThreadPool · Deterministic Parsing
WHY
모델 학습과 공동도급 매칭에 필요한 분야별 지분과 시공능력 기준은 공고 API가 아니라 첨부된 HWP·PDF 안에만 있었습니다. 하루 약 2,000개의 신규 문서를 사람이 직접 열어보는 방식으로는 feature 생성과 고객사 매칭을 실시간으로 처리할 수 없었습니다. 문서를 자동으로 구조화하면서도 금액과 비율은 다시 계산하고 확인할 수 있는 처리 경로가 필요했습니다.
주요 필드 추출F1 0.985
HWP/HWPX·PDF 나라장터 공고문
일 처리량약 2,000건
신규 공고 자동 처리
수치 검증Deterministic
금액·비율·단위를 코드로 검증
HOW
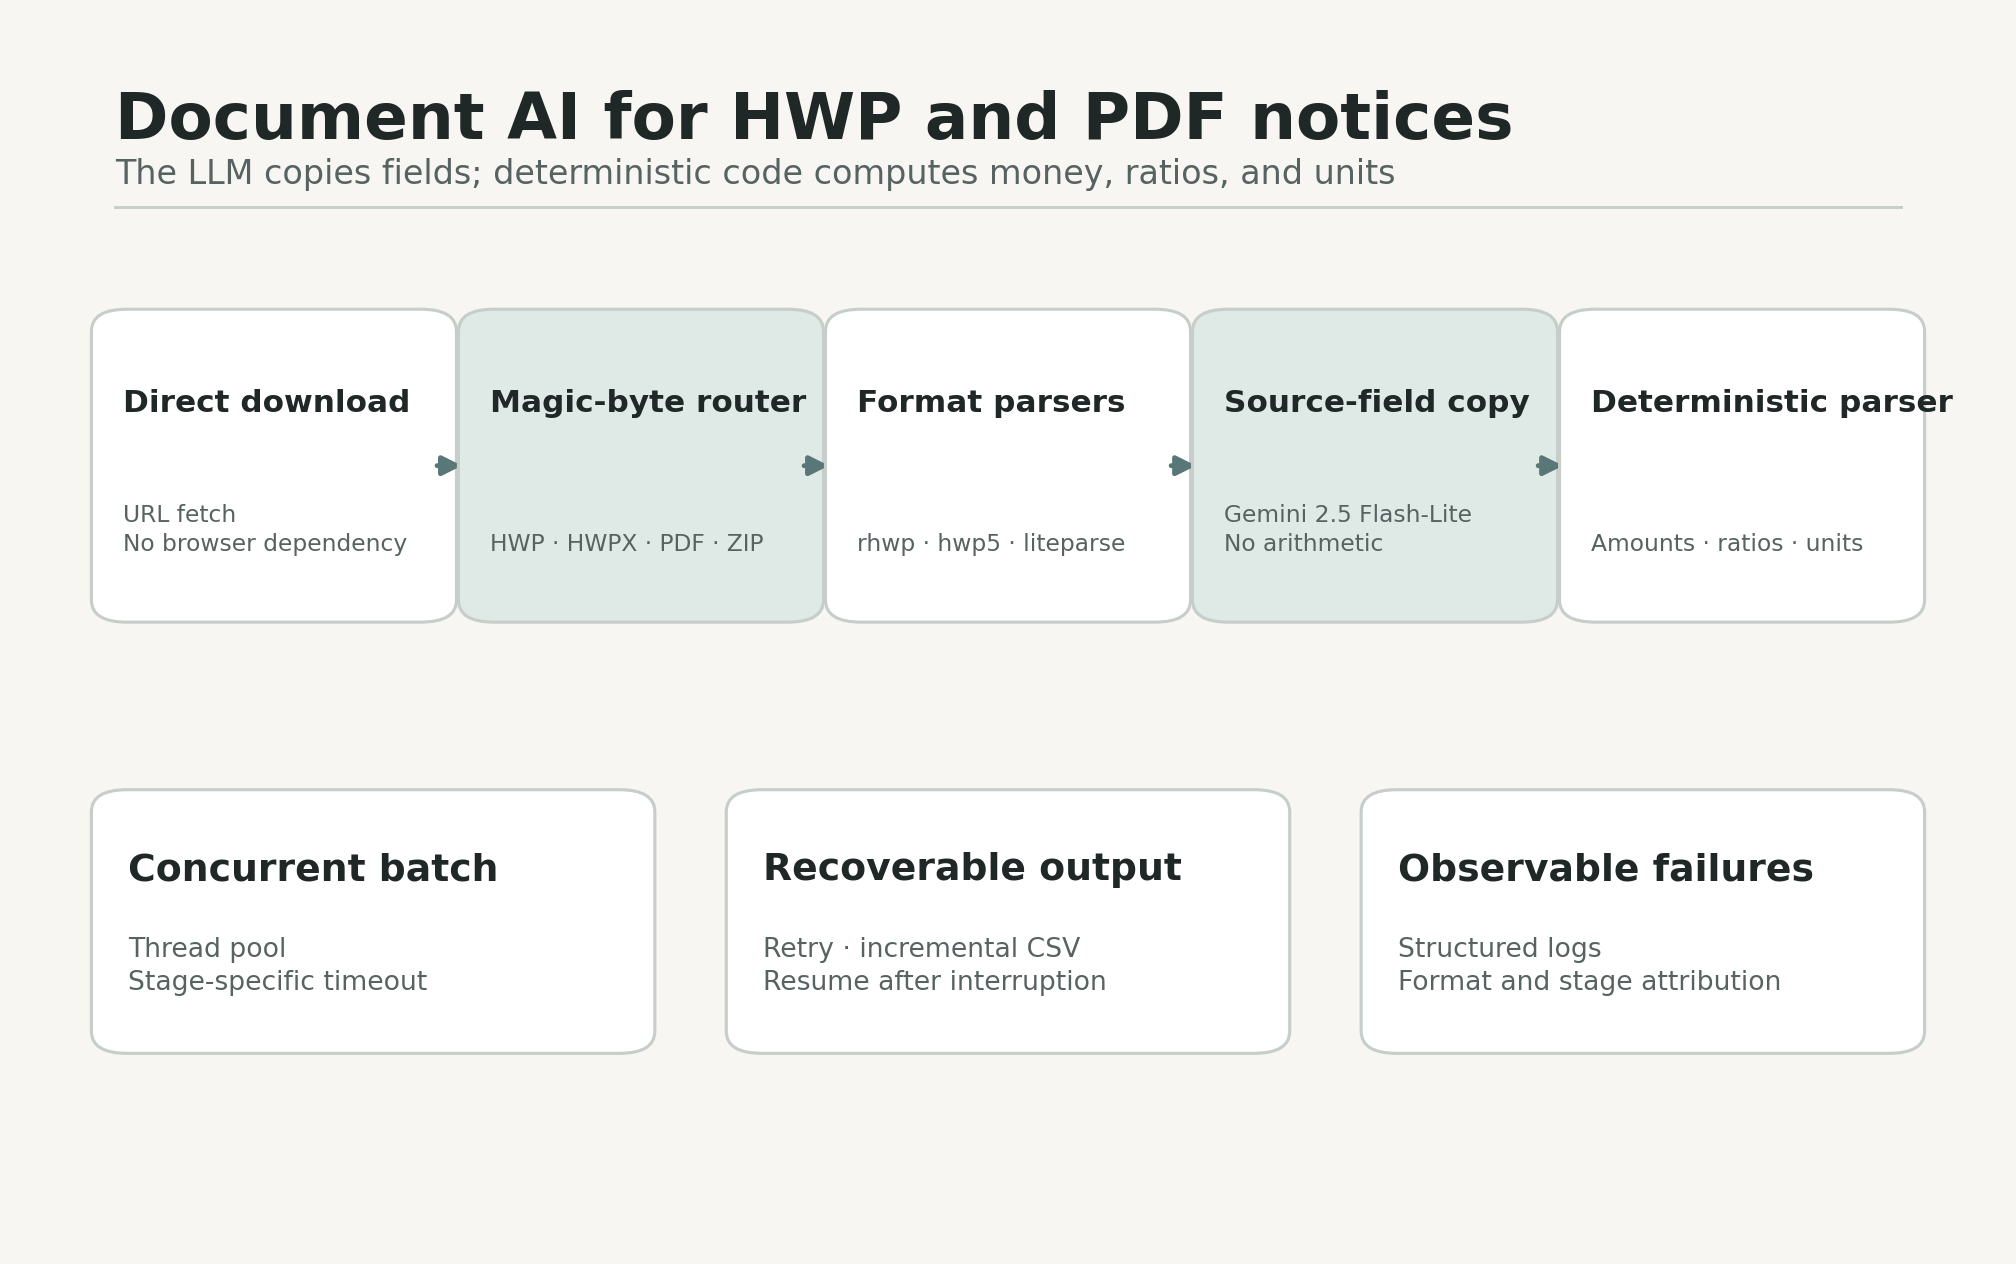
문서 복원, 필드 복사와 수치 계산을 분리합니다
각 단계에 한 가지 책임만 두어 extraction 오류의 위치를 찾고 수치 결과를 다시 계산할 수 있게 했습니다.
- 01직접 다운로드
브라우저 자동화 없이 URL에서 원본 byte를 내려받습니다.
- 02포맷 routing
파일명 대신 magic byte로 HWP, HWPX, PDF와 ZIP을 구분합니다.
- 03원문 복원
rhwp, hwp5와 liteparse를 포맷별 경로와 bounded retry로 실행합니다.
- 04필드 복사
Gemini 2.5 Flash-Lite가 복원된 원문에서 필요한 필드만 복사합니다.
- 05결정론적 계산
금액, 비율과 단위를 코드로 계산하고 구조화 output과 error log를 증분 저장합니다.
RESULT
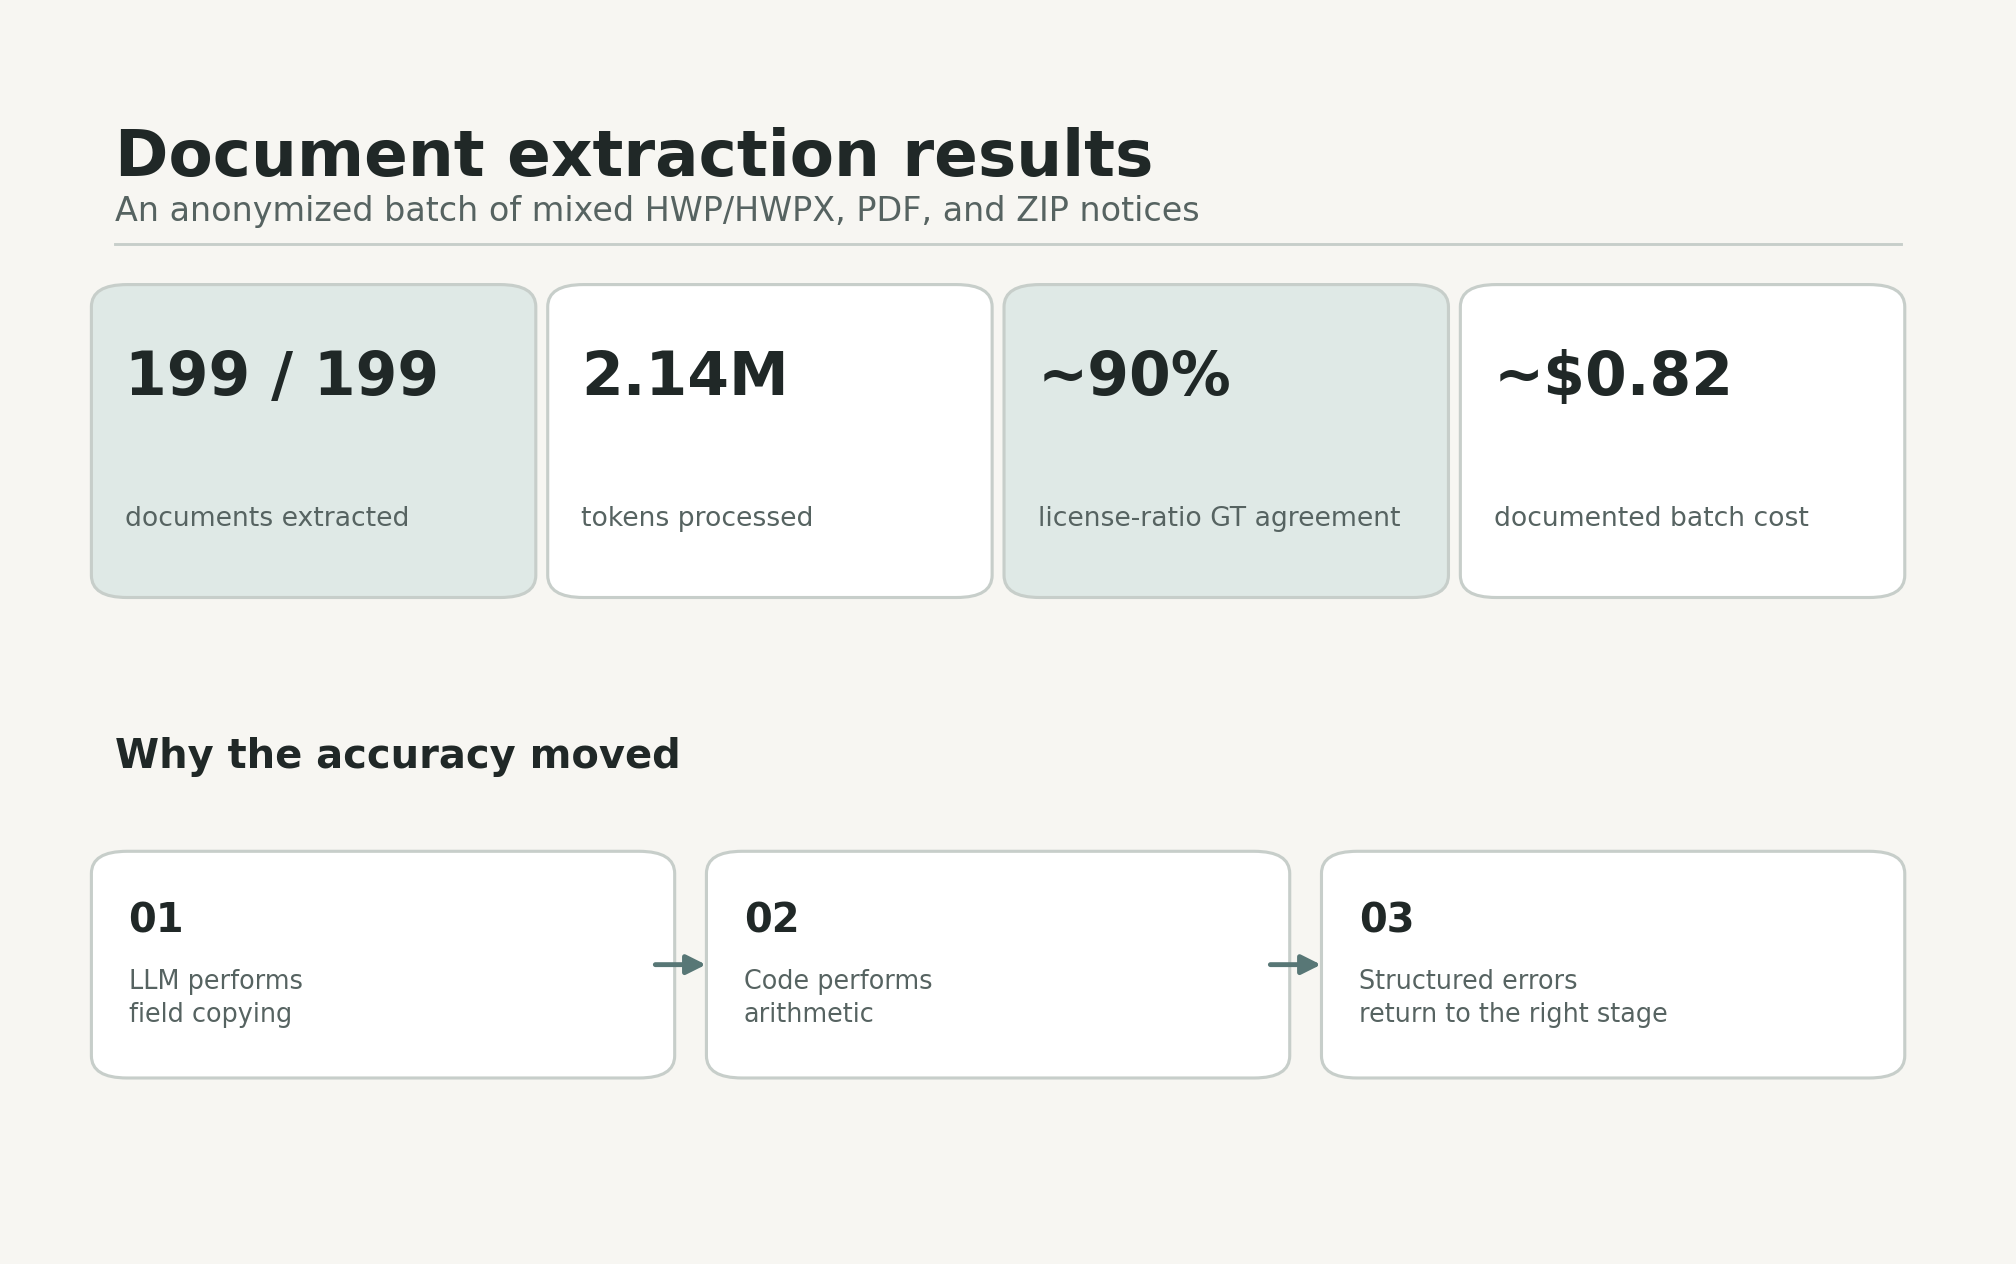
측정 extraction batch
| 지표 | 결과 | 의미 |
|---|---|---|
| 문서 | 199 / 199 | 측정 batch에서 extraction 실패 0건 |
| 원문 | 2,140,021 tokens | 긴 문서를 snippet으로 축약하지 않고 보존 |
| 업종별 비율 GT | 약 90% | 원문 필드 추출 후 결정론적 비율 처리 |
| 기록된 비용 | 약 $0.82 | 경량 모델을 이용한 batch 처리 |
기여
- 직접 다운로드, magic-byte routing, parser fallback과 결정론적 수치 처리의 경계를 설계했습니다.
- 단계별 timeout, retry, 증분 CSV와 구조화 error attribution을 포함한 동시 batch 처리를 구현했습니다.
관련 자료
비공개 프로젝트